Aula 01 - Arquitetura de Computadores, Microprocessadores vs. Microcontroladores
1. Visão Geral e Evolução Histórica da Computação Embarcada
A evolução dos sistemas computacionais foi impulsionada pela miniaturização dos circuitos integrados monolíticos de silício. Historicamente, os primeiros computadores eletrônicos operavam com dezenas de placas de circuitos discretos e válvulas termoionicas, evoluindo na década de 1970 para o primeiro microprocessador comercial de chip único do mundo — o Intel 4004 (4 bits, 1971) e o célebre Intel 8080 (8 bits, 1974).
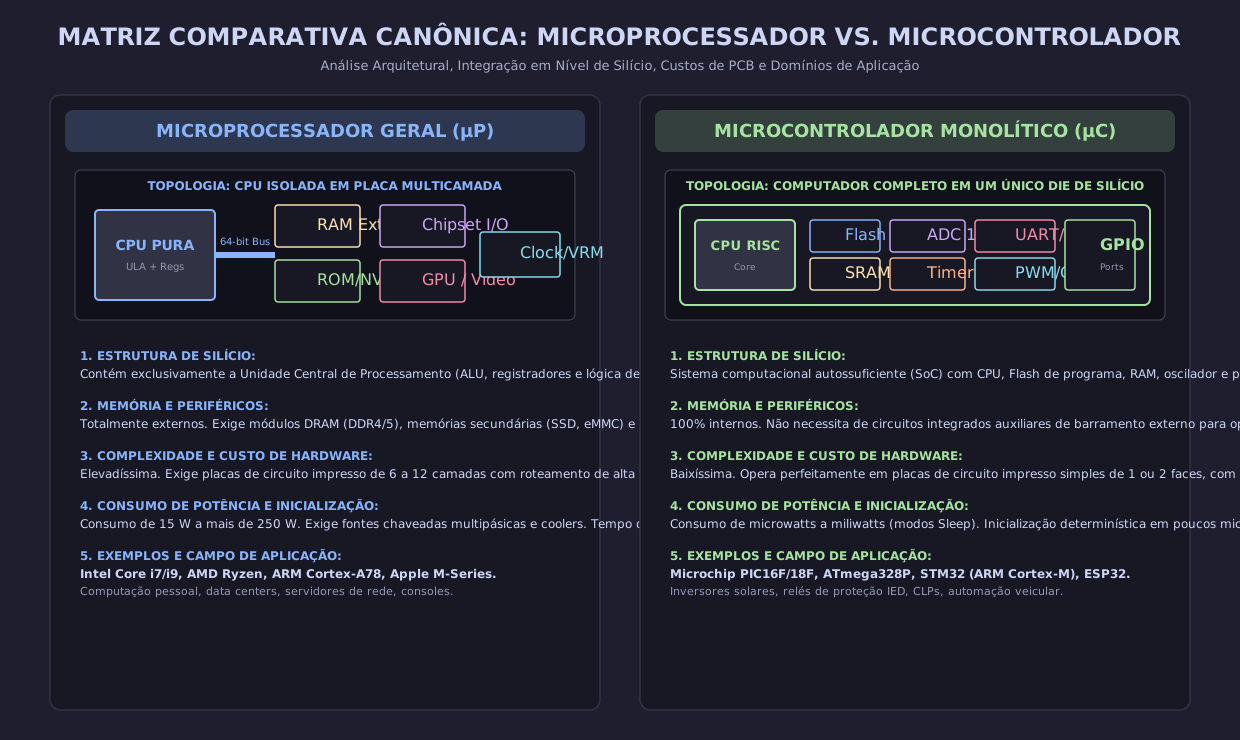
No entanto, a criação de sistemas dedicados para controle de processos físicos e automação industrial revelou uma cisão tecnológica fundamental entre duas filosofias construtivas distintas: os Microprocessadores de Propósito Geral (Microprocessors - ) e os Microcontroladores (Microcontrollers - ).
2. Paradigmas de Arquitetura: Von Neumann vs. Harvard
A organização de barramentos (buses) de comunicação entre a Unidade Central de Processamento (UCP) e o subsistema de memória define o desempenho e a vazão máxima de instruções (throughput):
2.1 A Arquitetura Von Neumann e o Gargalo Clássico
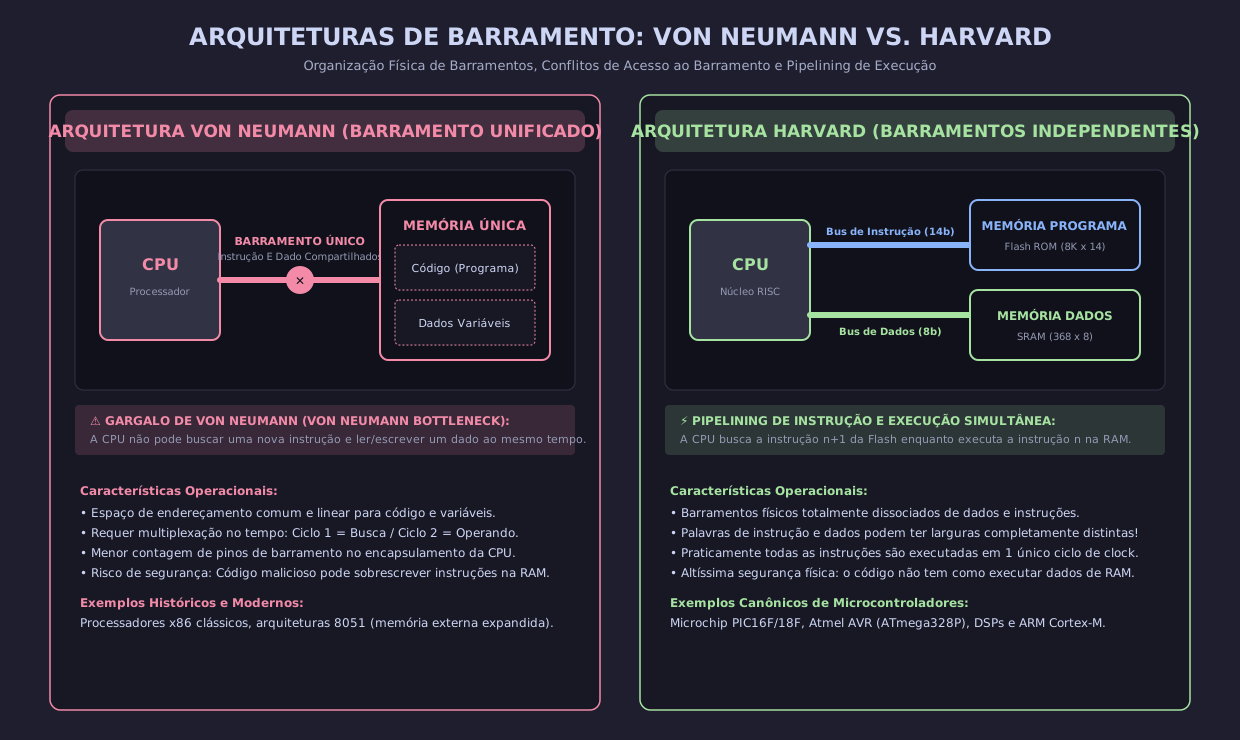
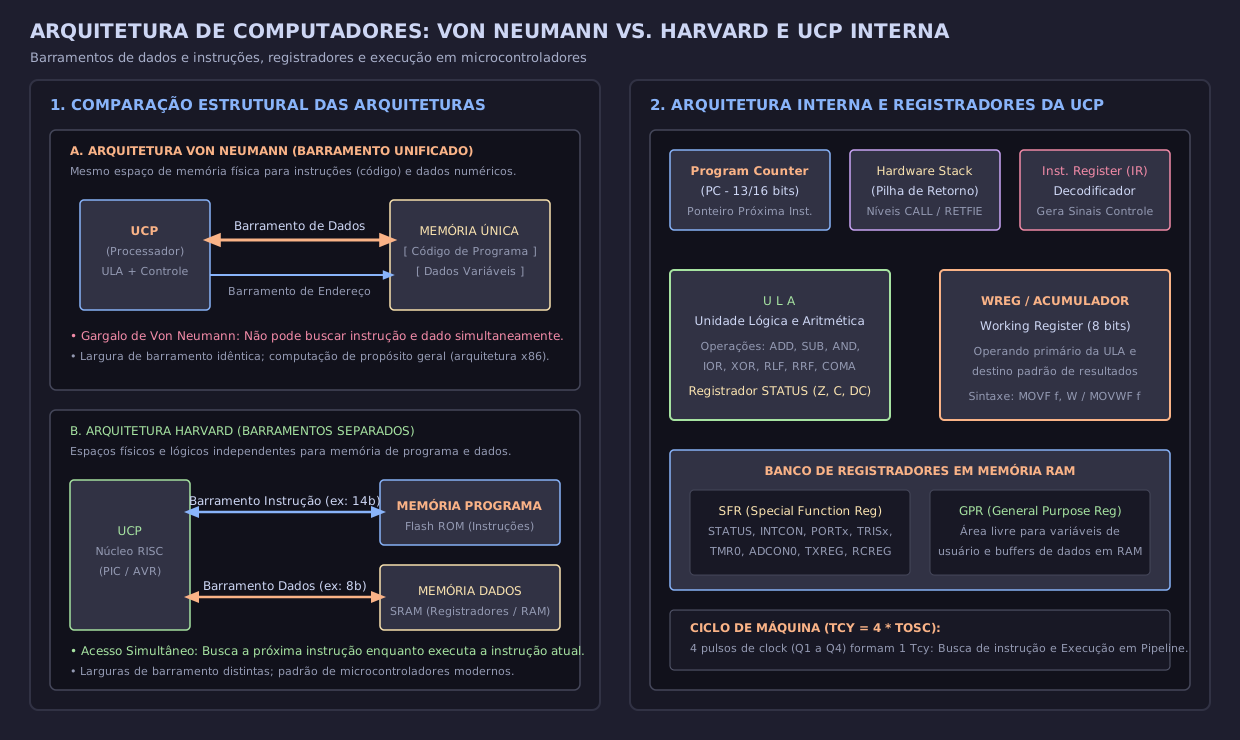
No modelo de John von Neumann (1945), dados de variáveis e instruções executáveis compartilham exatamente a mesma estrutura física de memória e os mesmos barramentos de endereço e de dados. Consequentemente:
- Uma operação que exige leitura de operando em memória demanda no mínimo dois ciclos sequenciais de barramento: o ciclo de busca da instrução (Instruction Fetch) e o subsequente ciclo de busca do operando (Data Fetch).
- Essa restrição física é consagrada na literatura como o Gargalo de Von Neumann (Von Neumann Bottleneck), limitando a velocidade de processamento pela largura de banda da memória.
2.2 A Arquitetura Harvard e o Pipelining em Microcontroladores
Concebida no desenvolvimento do computador Harvard Mark I, esta arquitetura isola física e logicamente a memória de programa da memória de dados:
- O barramento de endereços e o barramento de dados de instrução são independentes do barramento de dados de memória RAM.
- Larguras de Palavra Assimétricas: Em microcontroladores como a família PIC16F, a memória de instruções possui palavras de de largura, permitindo que o código de operação (opcode) e o endereço literal do operando residam na mesma palavra, enquanto a memória RAM de dados opera em palavras padrão de .
- Sobreposição em Pipeline (Pipelining): Enquanto a UCP decodifica e executa a instrução manipulando registradores na RAM, o barramento de instruções busca concorrentemente a instrução na memória Flash. Desta forma, a grande maioria das instruções de máquina é executada em um único ciclo de instrução ().
3. Conjuntos de Instruções: CISC vs. RISC
A filosofia de projeto do repertório de instruções que a UCP é capaz de decodificar e processar divide-se em duas vertentes:
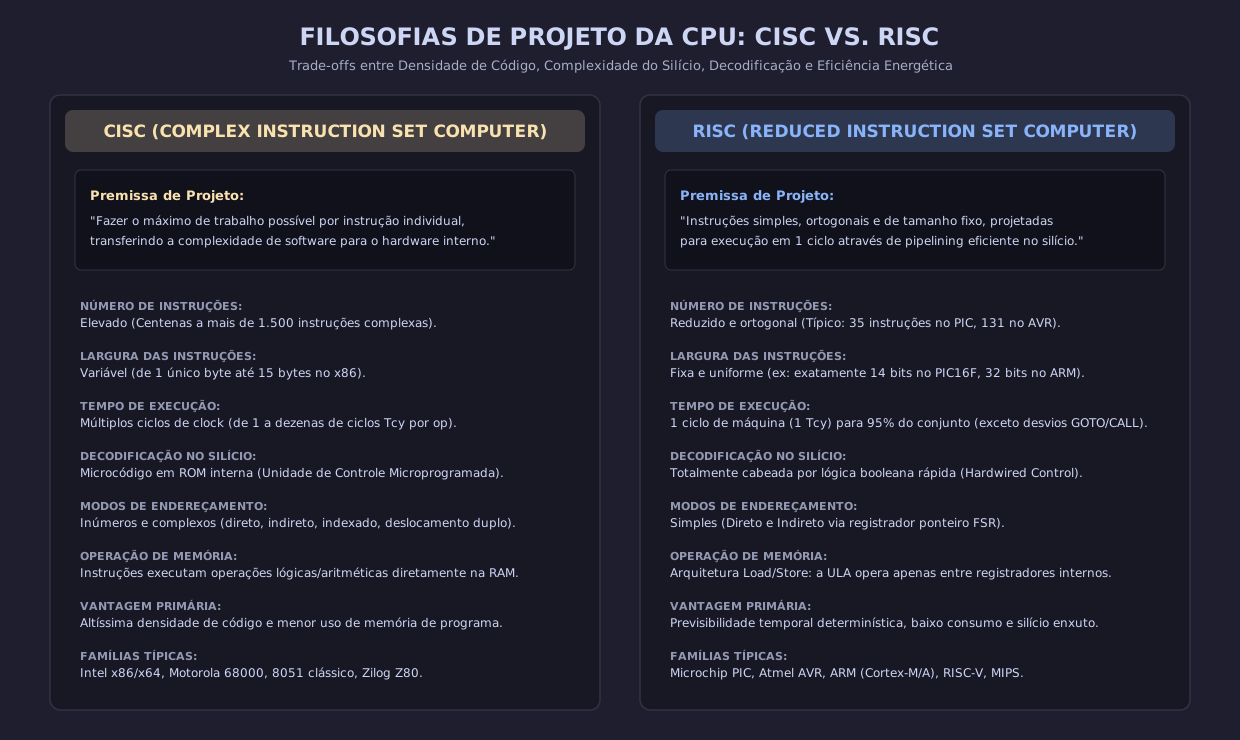
Em sistemas embarcados em tempo real, a arquitetura RISC prevalece amplamente devido à simplicidade da lógica cabeada, menor consumo de silício e, fundamentalmente, previsibilidade matemática determinística: o projetista sabe exatamente quantos ciclos de máquina cada instrução consome.
4. Arquitetura Interna da Unidade Central de Processamento (UCP)
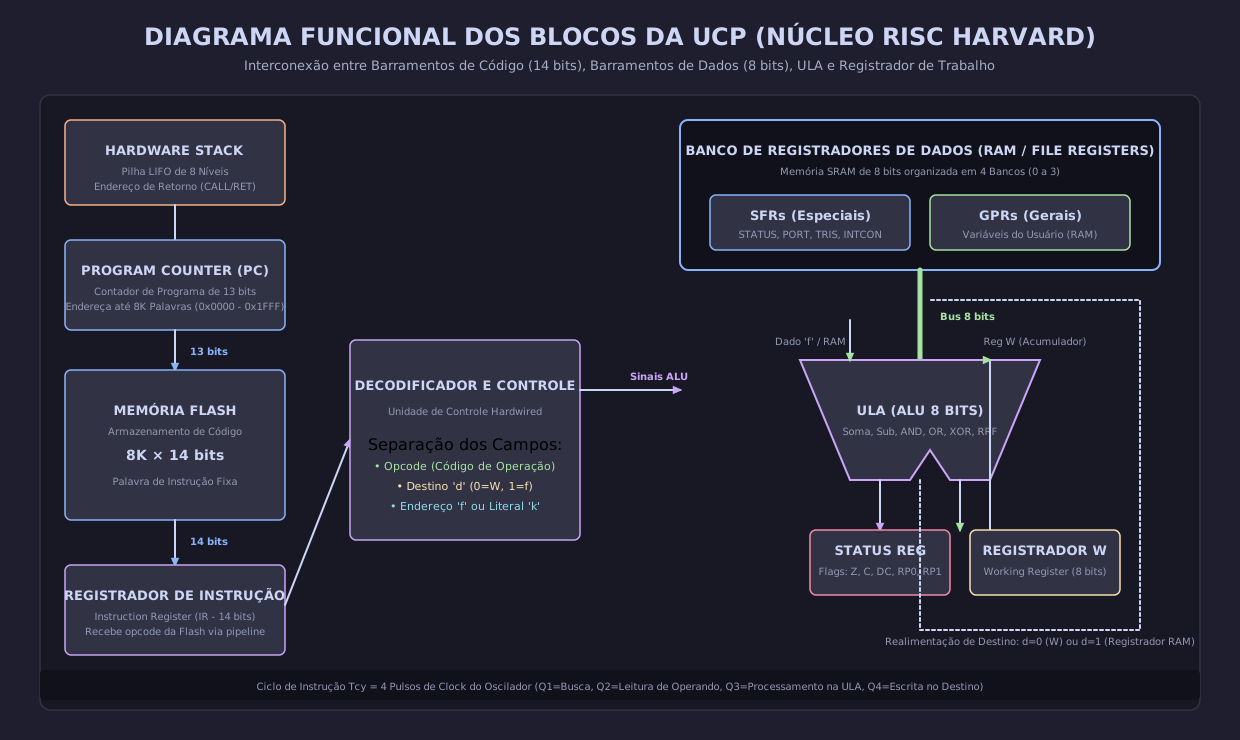
A UCP do microcontrolador orquestra o ciclo perpétuo de Busca (Fetch), Decodificação (Decode) e Execução (Execute). Seus módulos constituintes são detalhados a seguir:
4.1 O Contador de Programa (PC) e a Pilha (Stack)
O Contador de Programa (Program Counter - PC) armazena o endereço da memória de programa que contém a próxima instrução a ser buscada. Na família PIC16F877A, por exemplo, o PC possui , permitindo endereçar diretamente palavras de programa ().
Quando ocorre uma chamada de sub-rotina (CALL) ou uma interrupção de hardware:
- O endereço de retorno () é empilhado (PUSH) automaticamente em uma Pilha de Hardware (Hardware Stack) de múltiplos níveis (8 níveis no PIC16F e 31 níveis no PIC18F);
- O PC é carregado com o endereço da sub-rotina ou com o vetor de interrupção ();
- Ao término, a instrução de retorno (
RETURNouRETFIE) desempilha (POP) o endereço de volta para o PC, retomando a execução do fluxo principal.
CAUTION
A pilha de hardware em núcleos RISC básicos opera de forma circular e não possui verificação automática de limite. Se o software aninhar chamadas de funções recursivas em profundidade superior ao número físico de níveis, ocorre o temido Stack Overflow, sobrescrevendo os endereços mais antigos e provocando travamento irreversível do sistema!
4.2 A Unidade Lógica e Aritmética (ULA) e o Registrador de Trabalho (WREG)
A ULA de 8 bits executa operações aritméticas fundamentais (soma, subtração, incremento, decremento) e operações lógicas booleanas (AND, OR, XOR, deslocamentos e rotações de bits através do Carry).
Em microcontroladores PIC, um dos operandos da ULA deve ser obrigatoriamente o registrador acumulador WREG (Working Register). O resultado da operação pode ser direcionado por projeto de volta para o WREG () ou para o próprio registrador de arquivo na memória RAM (), governado pelo bit de destino contido no opcode:
4.3 O Registrador de Estado (STATUS)
O registrador especial STATUS (endereço na RAM) armazena os flags aritméticos resultantes da última operação processada pela ULA:
- Bit 2 - Zero (): Setado em se o resultado da operação for exatamente zero; limpo em caso contrário.
- Bit 1 - Digit Carry (): Setado em se houver transporte do bit 3 para o bit 4 (nibble inferior), essencial para aritmética decimal BCD.
- Bit 0 - Carry/Borrow (): Setado em se houver transporte para fora do bit 7 mais significativo em somas, ou se não houver empréstimo em subtrações.
- Bits 6:5 - RP1:RP0: Seleção de banco da memória RAM (Banco 0, 1, 2 ou 3).
5. Base de Tempo e Ciclo de Máquina ()
A base de tempo de um microcontrolador é fornecida por um circuito oscilador alimentado por cristal de quartzo piezoelétrico, ressonador cerâmico ou circuito RC interno configurado nos fusíveis de programação (Configuration Bits):
Internamente, a frequência de clock é dividida por quatro () por um divisor de quadratura de fase que gera quatro sinais internos de relógio defasados de : e . O período desses quatro pulsos combinados constitui o Ciclo de Máquina ou Ciclo de Instrução ():
Exemplo Numérico de Cálculo Temporal:
Para um microcontrolador com cristal de quartzo clássico de : A taxa de execução de instruções atinge:
- Instruções Lineares de 1 ciclo (): Executam em exatos (ex:
MOVF,ADDWF,BSF,BCF). - Instruções de Salto de 2 ciclos (): Desvios de fluxo (
GOTO,CALL,RETURN, ou saltos condicionais comoBTFSSquando o teste é verdadeiro) forçam o esvaziamento (flush) da instrução previamente buscada em pipeline, exigindo um ciclo nulo adicional ().
6. Organização e Mapeamento da Memória RAM (Bancos de Memória)
A memória SRAM interna é mapeada como uma matriz contígua de registradores de 8 bits dividida em bancos lógicos para contornar a limitação de bits de endereço no formato da instrução. Cada banco divide-se estruturalmente em:
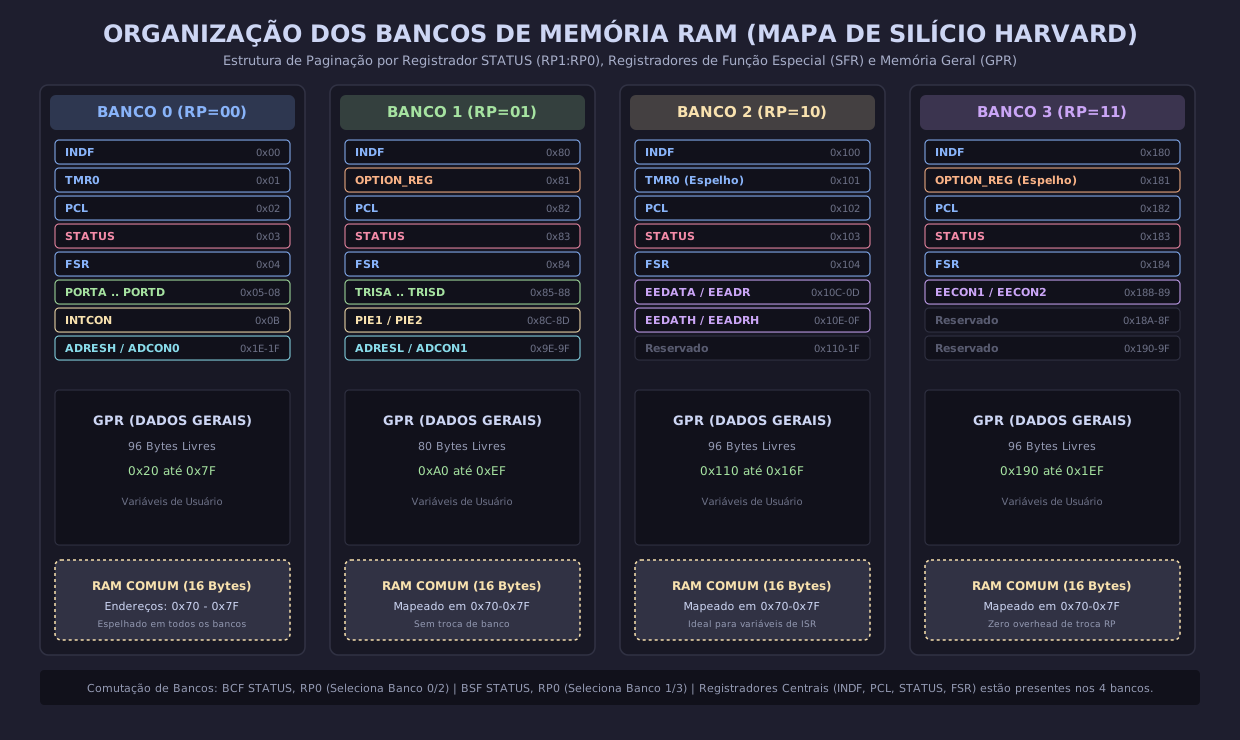
- Registradores de Funções Especiais (SFR - Special Function Registers): Ocupam os endereços baixos de cada banco e controlam diretamente o hardware periférico (portas I/O, temporizadores, conversores analógico-digitais, módulos de comunicação e interrupção).
- Registradores de Propósito Geral (GPR - General Purpose Registers): Memória RAM estática livre para o programador armazenar variáveis, matrizes e dados dinâmicos do firmware.
7. Diagrama Arquitetural Consolidado
O diagrama técnico vetorial a seguir ilustra a comparação detalhada entre as arquiteturas Von Neumann e Harvard, com destaque para a segregação de barramentos e a estrutura interna dos registradores e blocos funcionais da UCP:
8. Exercícios Resolvidos e Aplicações em Concursos
Exercício 1 (Petrobras - Engenharia de Telecomunicações / CESGRANRIO)
Enunciado: Um sistema de monitoração de vibração mecânica baseado em microcontrolador de arquitetura Harvard RISC opera com cristal oscilador de . O microcontrolador consome 4 ciclos de oscilador para cada ciclo de instrução (). Uma rotina de interrupção em código Assembly que executa a leitura de um canal e armazena em buffer é composta rigorosamente por:
- instruções lineares de ;
- instruções de desvio/salto condicional de ;
- instrução de retorno de interrupção (
RETFIE) de .
Calcule:
- O período do ciclo de máquina e a capacidade nominal de processamento em MIPS.
- O tempo exato em microssegundos consumido para executar integralmente a rotina de interrupção.
- A taxa máxima teórica de requisições de interrupção por segundo que o processador suportaria se dedicasse do seu tempo exclusivamente a essa rotina.
Resolução Passo a Passo:
-
Cálculo de e MIPS:
-
Tempo Total de Execução da Rotina ISR: Total de ciclos de máquina consumidos: Tempo total da rotina:
-
Taxa Máxima de Interrupções por Segundo:
Exercício 2 (Marinha do Brasil - Corpo de Engenheiros)
Enunciado: Explique fundamentadamente por que a arquitetura Harvard associada ao conjunto de instruções RISC permite implementar a técnica de pipelining de 2 estágios em microcontroladores de forma substancialmente mais eficiente do que uma arquitetura Von Neumann CISC. Demonstre o impacto de um desvio de fluxo incondicional (GOTO) sobre o desempenho do pipeline.
Resolução Analítica e Conceitual:
- Independência de Barramentos na Arquitetura Harvard: Na arquitetura Harvard, os barramentos de memória de instruções (Flash) e de memória de dados (RAM) são completamente segregados. Isso viabiliza o paralelismo temporal estrito: durante o intervalo de tempo do ciclo , a UCP utiliza o barramento de dados para ler ou escrever operandos na memória RAM correspondentes à instrução , enquanto simultaneamente e de forma independente o barramento de programa busca a próxima instrução na Flash ROM.
- Homogeneidade e Tamanho Fixo das Instruções RISC: Em arquiteturas RISC, todas as instruções possuem exatamente o mesmo comprimento físico de palavra (ex: 14 bits no PIC16, 16 bits no AVR). Isso elimina a necessidade de múltiplos ciclos de busca para decodificar o tamanho da instrução (típico do CISC x86), permitindo que a decodificação seja realizada por lógica booleana cabeada instantânea em vez de microrotinas sequenciais lentas.
- Impacto do Desvio de Fluxo (
GOTO/CALL): O pipeline antecipa a busca da instrução subsequente linear (). Quando a instrução executada é um salto (GOTO k), o fluxo linear é quebrado: a instrução previamente buscada torna-se inválida e deve ser descartada do registrador de instrução. A UCP é forçada a executar uma bolha no pipeline (pipeline stall ou flush), consumindo um ciclo nulo enquanto o novo endereço é carregado no PC e a instrução de destino é buscada. Por essa razão, em processadores RISC:- Instruções que não alteram o PC consomem exatamente ;
- Instruções de desvio que carregam novo endereço no PC consomem obrigatoriamente .